Megatron-LM 并行策略#
本页内容12 个部分
查看概览图
两条 RankGenerator 路径
约束住七种并行的组合
不是「一个公式覆盖所有」——Dense 与 MoE 两条路径各有自己的 RankGenerator,七种策略在进程组约束下组合。
world_size = TP × CP × DP × PPDP 不用手动指定:DP = world / (TP×CP×PP)
world_size = ETP × EP × expert_DP × PPexpert_DP 同样自动推导;ETP 默认 = TP
AllReduce · ReduceScatter
AllGather · ReduceScatter
P2P Send/Recv
AllReduce(+ ZeRO-1/2)
Ring P2P · AllToAll
AllToAll(Token 路由)
独立 TP 组
① world 整除 TP×CP×PP;② 单个 RankGenerator 不混合 EP 与 CP;两套生成器允许全局 CP、EP 同时 >1;③ VPP 要求 PP>1;④ SP 要求 TP>1;⑤ world 整除 ETP×EP×PP,ETP 默认 = TP;⑥ order 不以 pp 结尾时两路 DP 须相等。
源码版本:Megatron-LM
core_v0.18.0(2026-06-22 release, commit ba7b5eb)。核心文件:megatron/core/parallel_state.py、model_parallel_config.py。
训练千亿参数模型,单卡装不下,就得把模型「拆」到成百上千张 GPU 上。怎么拆是关键——拆权重、拆激活、拆层、拆数据、拆序列、拆专家、拆专家内部权重,七种策略各有适用场景,并受源码里进程组和整除约束的限制。
一句话总览:
七种策略各司其职,由两条等式约束组合:Dense/Attention 路径
world = TP × CP × DP × PP,MoE Expert 路径world = ETP × EP × expert_DP × PP。SP 复用 TP 组(不单独占维度);DP、expert_DP 自动推导。
1. 全局:两条 RankGenerator 路径#
Megatron core_v0.18.0 里不是「一个公式覆盖所有」,而是 Dense 与 MoE 两条路径各有自己的 RankGenerator:
Dense / Attention:  world_size = TP × CP × DP × PP
MoE Expert:         world_size = ETP × EP × expert_DP × PP
Dense 路径的 DP 不用手动指定(parallel_state.py L733–738):
model_size = tensor_model_parallel_size * pipeline_model_parallel_size * context_parallel_size
if world_size % model_size != 0:
    raise RuntimeError(f"world_size ({world_size}) is not divisible by {model_size}")
data_parallel_size = world_size // model_size      # DP = world /(TP×CP×PP)
| 缩写 | 拆的对象 | 核心通信 |
|---|---|---|
| TP | 权重矩阵(列/行切) | AllReduce / ReduceScatter |
| SP | 激活值(序列维) | AllGather / ReduceScatter(复用 TP 组) |
| PP | Transformer 层 | P2P Send/Recv |
| DP | 训练数据(梯度同步) | AllReduce(+分布式优化器 = ZeRO-1/2) |
| CP | 输入序列长度 | Ring P2P / AllToAll |
| EP | MoE 专家 | AllToAll(Token 路由) |
| ETP | 专家内部权重 | AllReduce / ReduceScatter(独立 TP 组) |
2. 张量并行(TP):把权重矩阵切开#
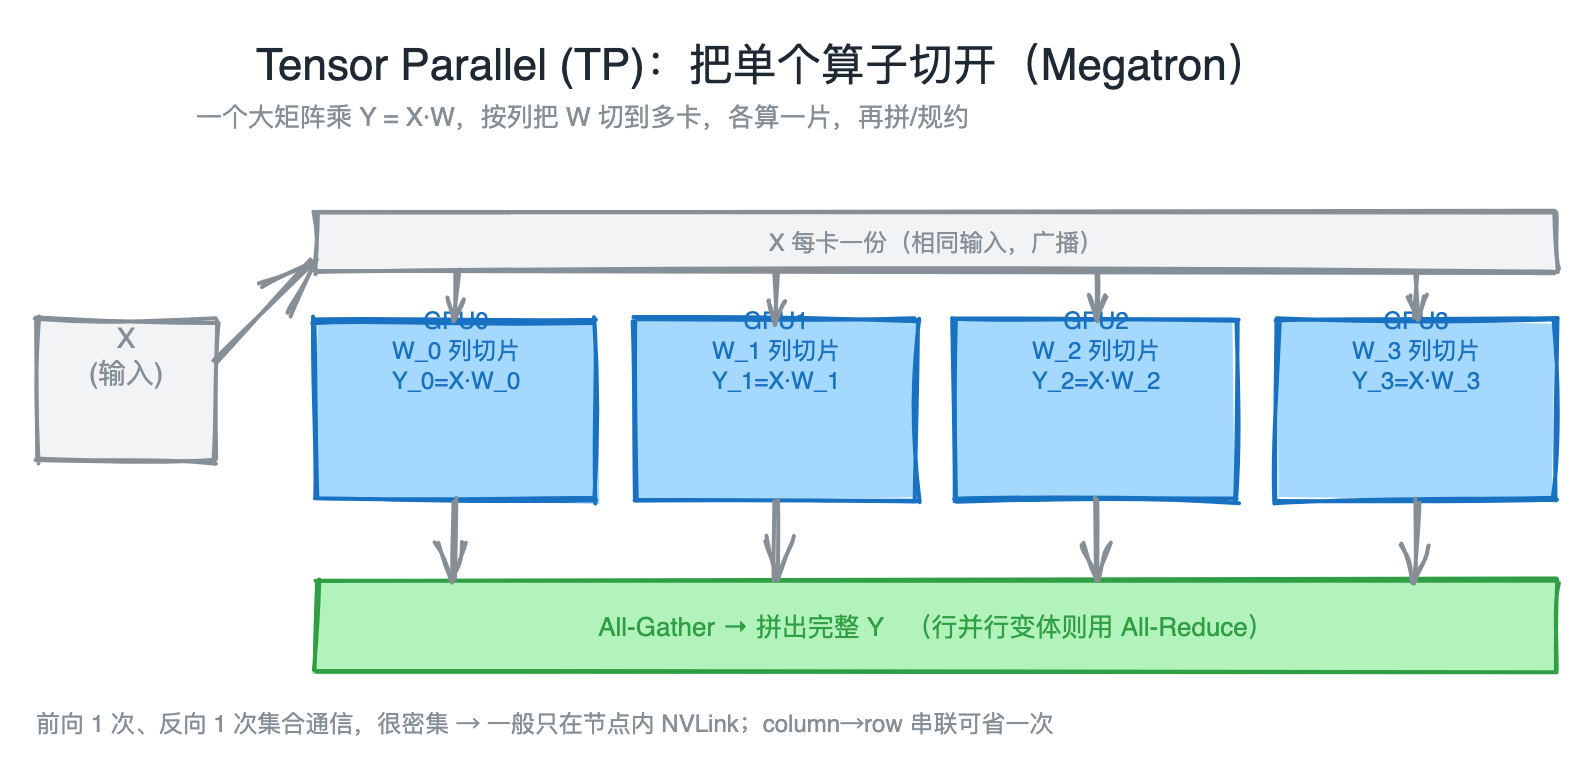
图源:Parallelism-TP.excalidraw(可编辑)
把单层的权重矩阵切到多卡。对线性层 ,Megatron 提供两种切法:
- 列并行
ColumnParallelLinear(layers.pyL778): 按列切,权重形状[out/TP, in],每卡算 (输出是完整 的一段)。 - 行并行
RowParallelLinear(layers.pyL1142): 按行切,输入也切,权重[out, in/TP],各卡算部分结果后 AllReduce 求和。
Transformer 里的巧妙搭配:MLP(第一层列并行、第二层行并行)、Attention(QKV 投影列并行、输出投影行并行)。「列在前、行在后」让两层之间只需 一次 AllReduce(或 ReduceScatter+AllGather),省掉中间通信。
通信非常密集(前向 1 次、反向 1 次集合通信)→ 一般只在节点内 NVLink做 TP。
3. 序列并行(SP):TP 的显存优化搭档#
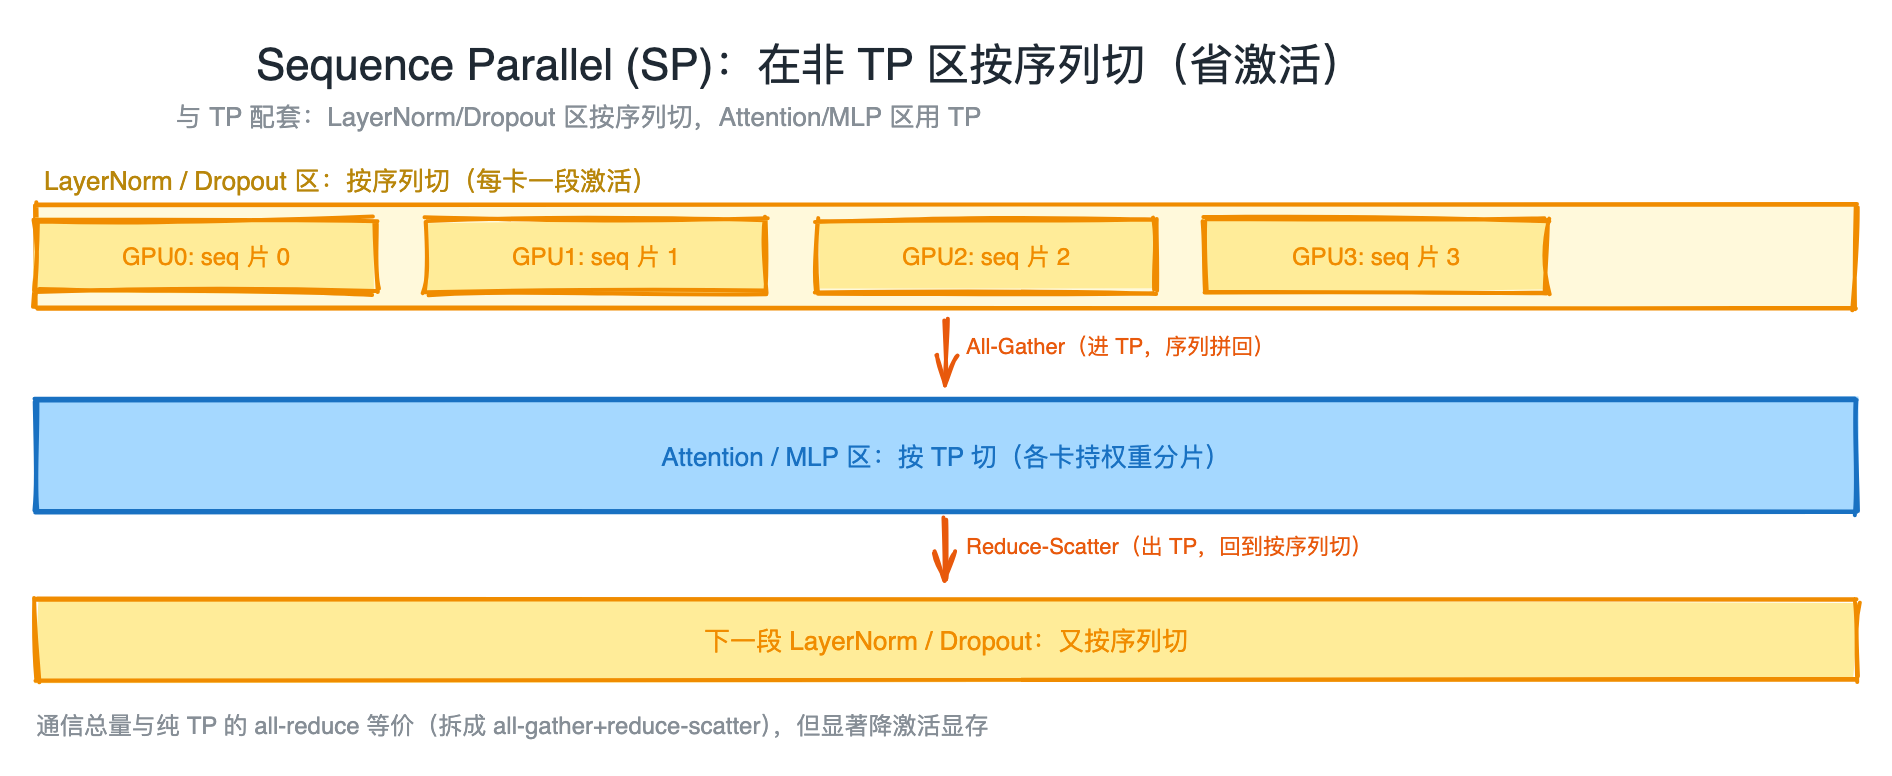
图源:Parallelism-SP.excalidraw(可编辑)
TP 切不了 LayerNorm / Dropout / 残差——纯 TP 下这些算子的激活在每卡都是完整副本,随序列长度膨胀成显存瓶颈。SP 在这些区域沿序列维切激活,每卡只存 1/TP 长度。
LayerNorm/Dropout 区:[seq/TP, batch, hidden]      ← 按序列切
   ↓ 进 TP 线性层前:AllGather → [seq, batch, hidden]
Attention/MLP 区(TP 切权重)
   ↓ RowParallel 输出后:ReduceScatter → [seq/TP, ...]
Dropout/残差:在切分后的激活上做,显存 1/TP
关键洞察:通信量不变。纯 TP 的 RowParallel 输出本要做一次 AllReduce(= ReduceScatter + AllGather);SP 只是把它拆成两步插到两层之间,却让中间区域省了 1/TP 激活显存。三个通信原语在 tensor_parallel/mappings.py L512–539。
约束:SP 要求 TP > 1(layers.py L952–958,否则自动关闭并告警);SP 复用 TP 组(_TENSOR_MODEL_PARALLEL_GROUP),所以不单独占 world-size 维度。
4. 流水线并行(PP):把层摞成流水线#
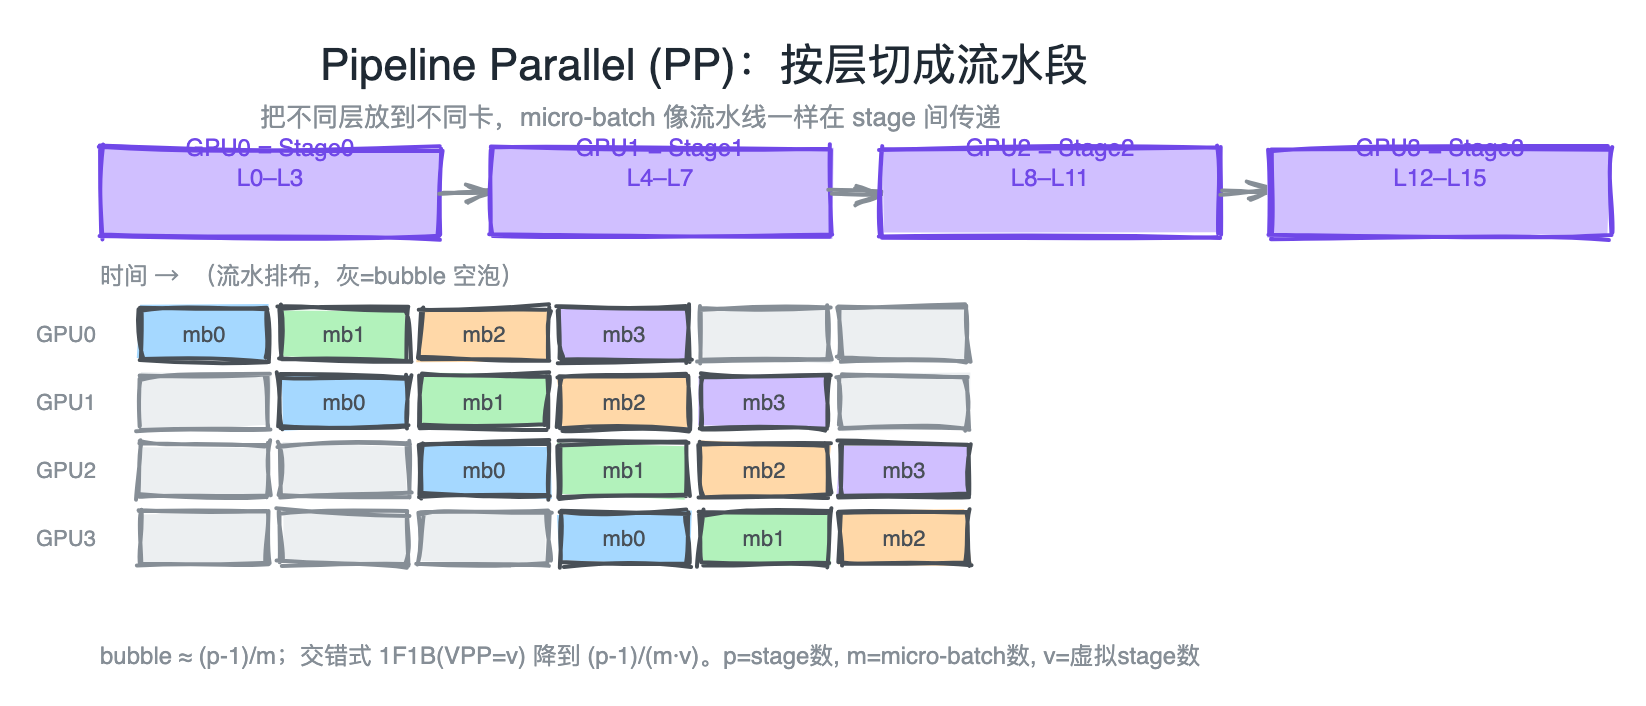
图源:Parallelism-PP.excalidraw(可编辑)
把 N 层按层切到不同卡(32 层、PP=4 → 每卡 8 层),数据像流水线依次过 stage,相邻 stage 间 P2P Send/Recv 传激活。核心问题是流水线气泡(bubble)。两种调度(pipeline_parallel/schedules.py):
- 1F1B(非交错,L2101):warmup 填满流水线后进入稳态,一前向接一反向。
- 交错式 1F1B(
virtual_pipeline_model_parallel_size>1,L958):每卡持有不连续的多组虚拟 stage。
16 层, PP=4, VPP=2:
GPU0: [L1,2]  [L9,10]     GPU1: [L3,4]  [L11,12]
GPU2: [L5,6]  [L13,14]    GPU3: [L7,8]  [L15,16]
理想均衡、忽略通信时,气泡时间相对有效计算时间的比值约为 ;非交错时,占总时间的气泡比例则为 (=stage 数, =micro-batch 数, =虚拟 stage 数)。代价是虚拟 stage 间通信增多。PP 还支持 UCC 后端,更省 GPU SM。约束:VPP 要求 PP > 1。
5. 数据并行(DP):最简单也最常用#
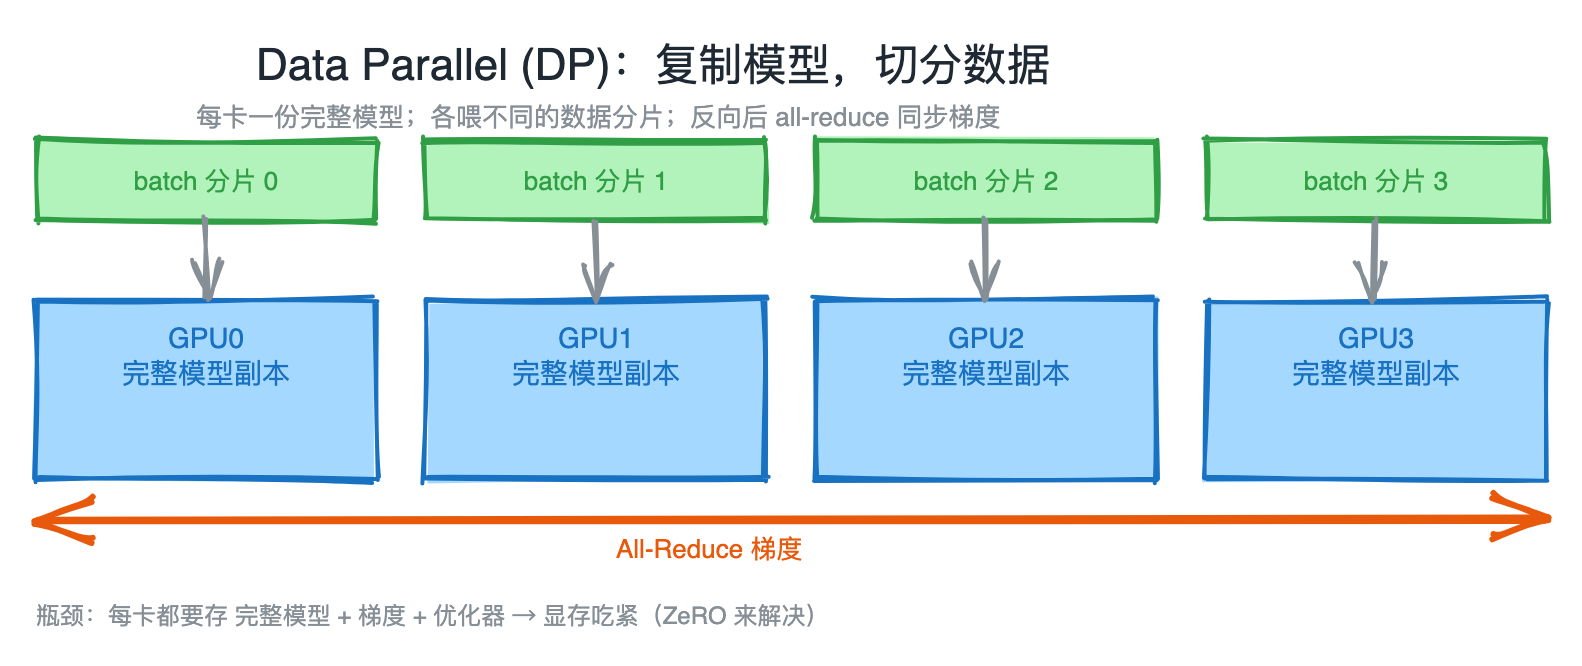
图源:Parallelism-DP.excalidraw(可编辑)
纯 DP 时每卡一份完整模型;与模型并行组合时,每个 DP 副本持有相应模型分片、喂不同数据,反向后 AllReduce 同步梯度。大小自动推导 DP = world /(TP×CP×PP)。Megatron 自实现的 DDP(distributed/distributed_data_parallel.py)优化:连续梯度缓冲区、分桶通信与反向计算重叠、可选 FP32 梯度累加。
分布式优化器(≈ ZeRO-1/2):启用 use_distributed_optimizer 后,优化器状态在相应数据并行组内分片;num_distributed_optimizer_instances 控制分布式优化器实例/分片组划分,取 1 也可使用分布式优化器。典型路径,用 ReduceScatter 替代 AllReduce 同步梯度,再 AllGather 广播更新后的参数:
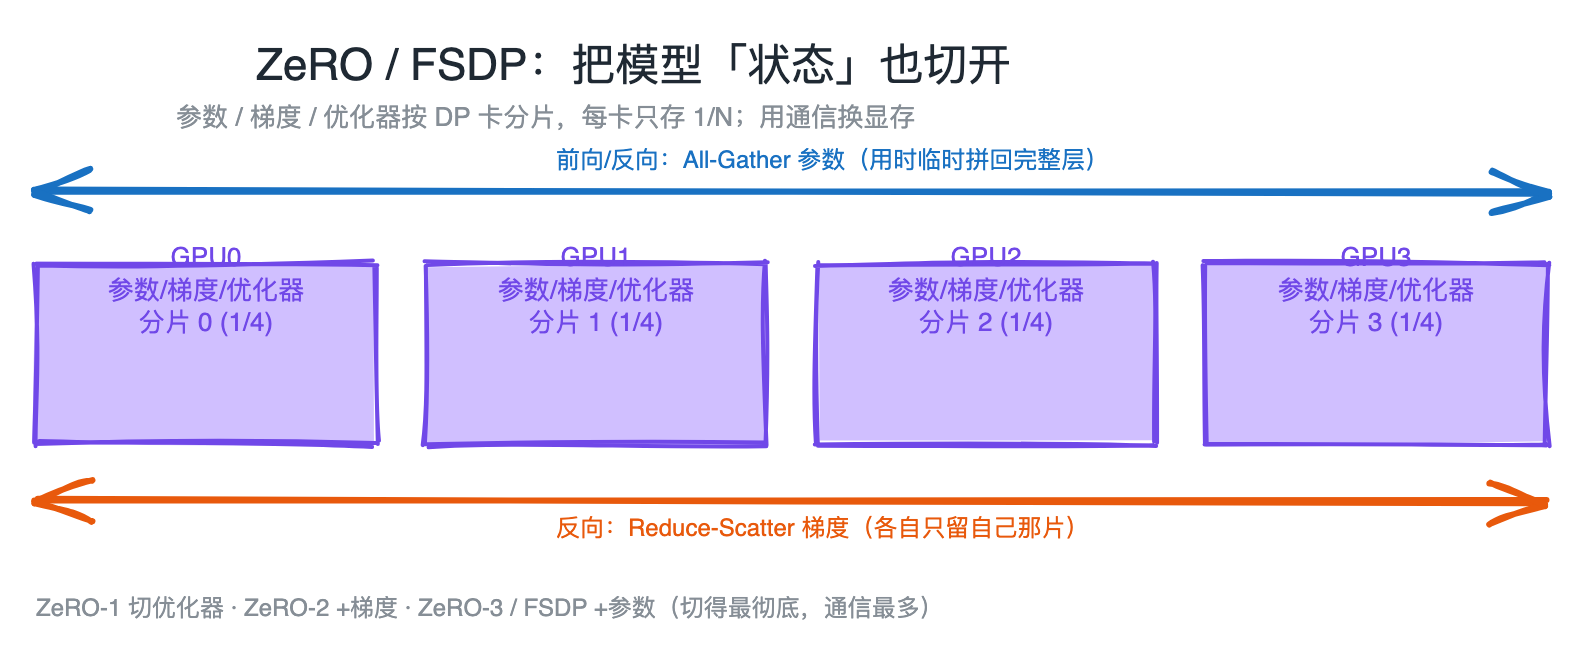
图源:Parallelism-ZeRO.excalidraw(可编辑)
ZeRO-1:切 优化器状态 · ZeRO-2:+ 梯度 · ZeRO-3 / FSDP:+ 参数(用通信换显存)
6. 上下文并行(CP):为长序列而生#
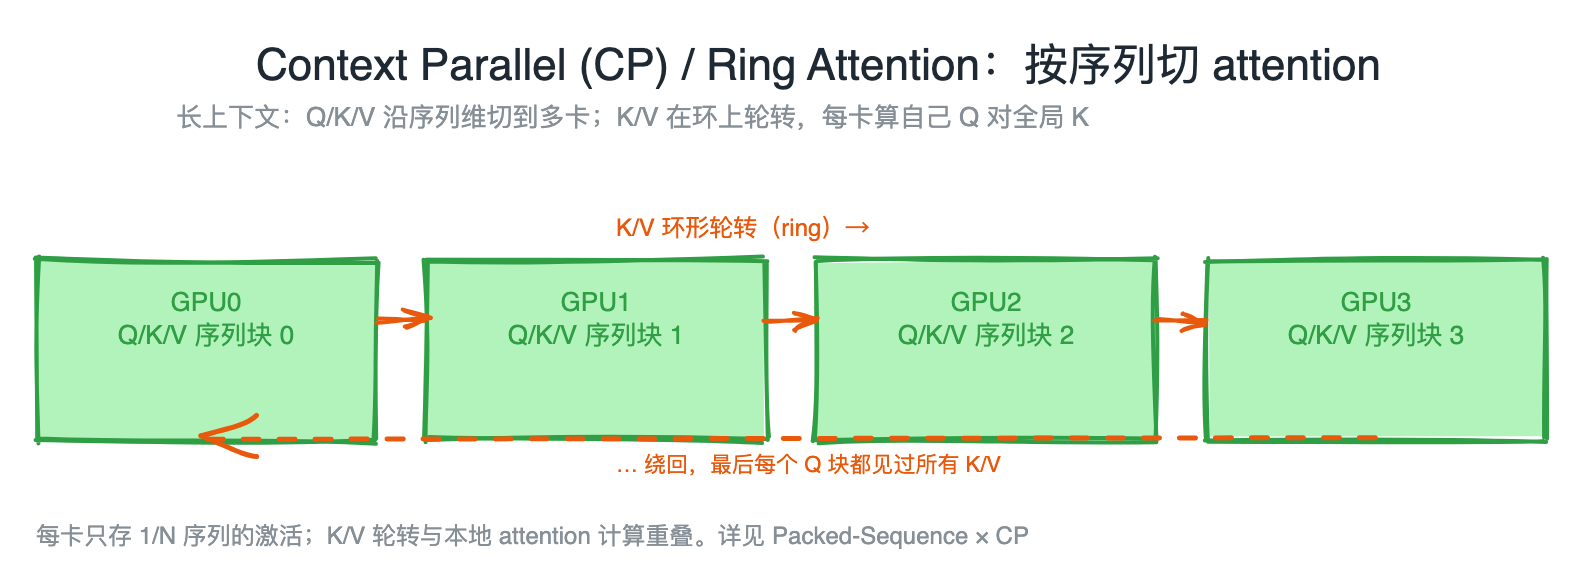
图源:Parallelism-CP.excalidraw(可编辑)
Self-Attention 开销随序列长度平方增长,128K/1M 序列单卡放不下。CP 把输入序列沿长度维切到多卡,每卡只持一段。但 attention 要每个 token 看到所有 token → CP 组内必须交换 KV。Megatron 通过 cp_comm_type 支持四种通信:
| 类型 | 机制 | 适用 |
|---|---|---|
p2p |
Ring Attention:KV 环形逐步传递 | 通用,NVLink 好 |
all_gather |
AllGather 收完整 KV 再算 | 简单,无法重叠 |
a2a |
AllToAll(Ulysses)按注意力头拆 | 头数多时高效 |
a2a+p2p |
分层混合:局部 A2A、跨组 P2P | 跨节点分层拓扑 |
关键交互:CP 与 DP 共享梯度同步组(CP 不切权重,梯度在 DP×CP 范围 AllReduce → _DATA_PARALLEL_GROUP_WITH_CP);单个 RankGenerator 中 EP 与 CP 不同时展开(断言 ep==1 or cp==1);attention 与 expert 使用两套生成器,因此不能据此禁止全局配置同时使用 CP>1 与 EP>1。详见 Packed Sequence × CP。
7. 专家并行(EP):MoE 专属#
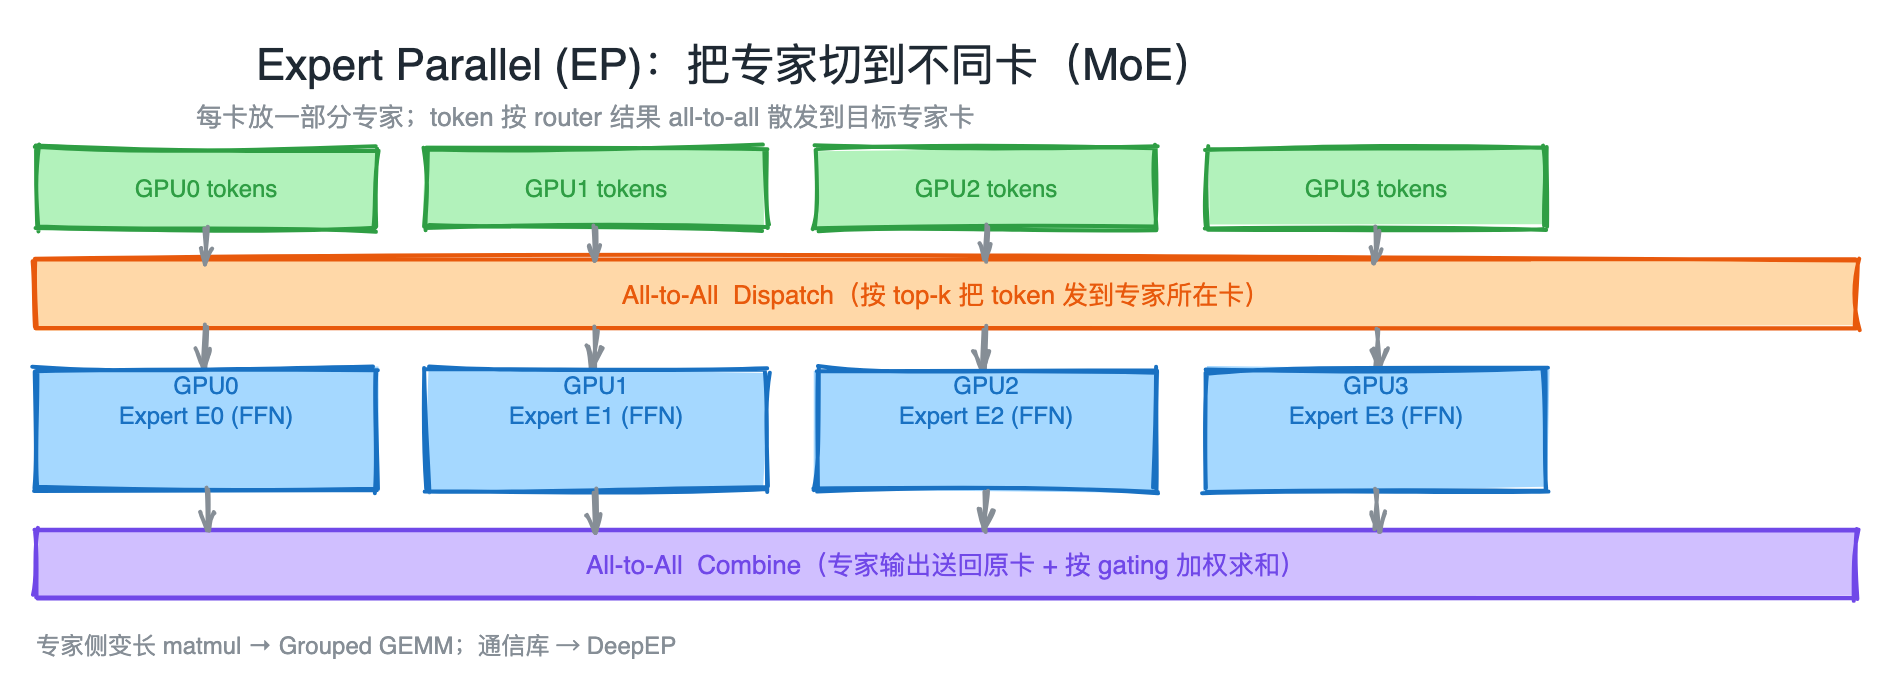
图源:Parallelism-EP.excalidraw(可编辑)
MoE 把每层 MLP 换成多个专家,Router 把 token 分给不同专家。EP 把不同专家放不同卡(64 专家、EP=8 → 每卡 8 个),token 经 AllToAll 路由到目标专家卡,算完再 AllToAll 返回。EP 有独立于 TP/DP 的进程组体系(_EXPERT_MODEL_PARALLEL_GROUP 等)。Token 分发三策略(moe/token_dispatcher.py):MoEAllGatherTokenDispatcher / MoEAlltoAllTokenDispatcher / MoEFlexTokenDispatcher。
专家侧变长 matmul 见 Grouped GEMM;高效 dispatch/combine 通信库见 DeepEP。
8. 专家张量并行(ETP):专家内部的 TP#
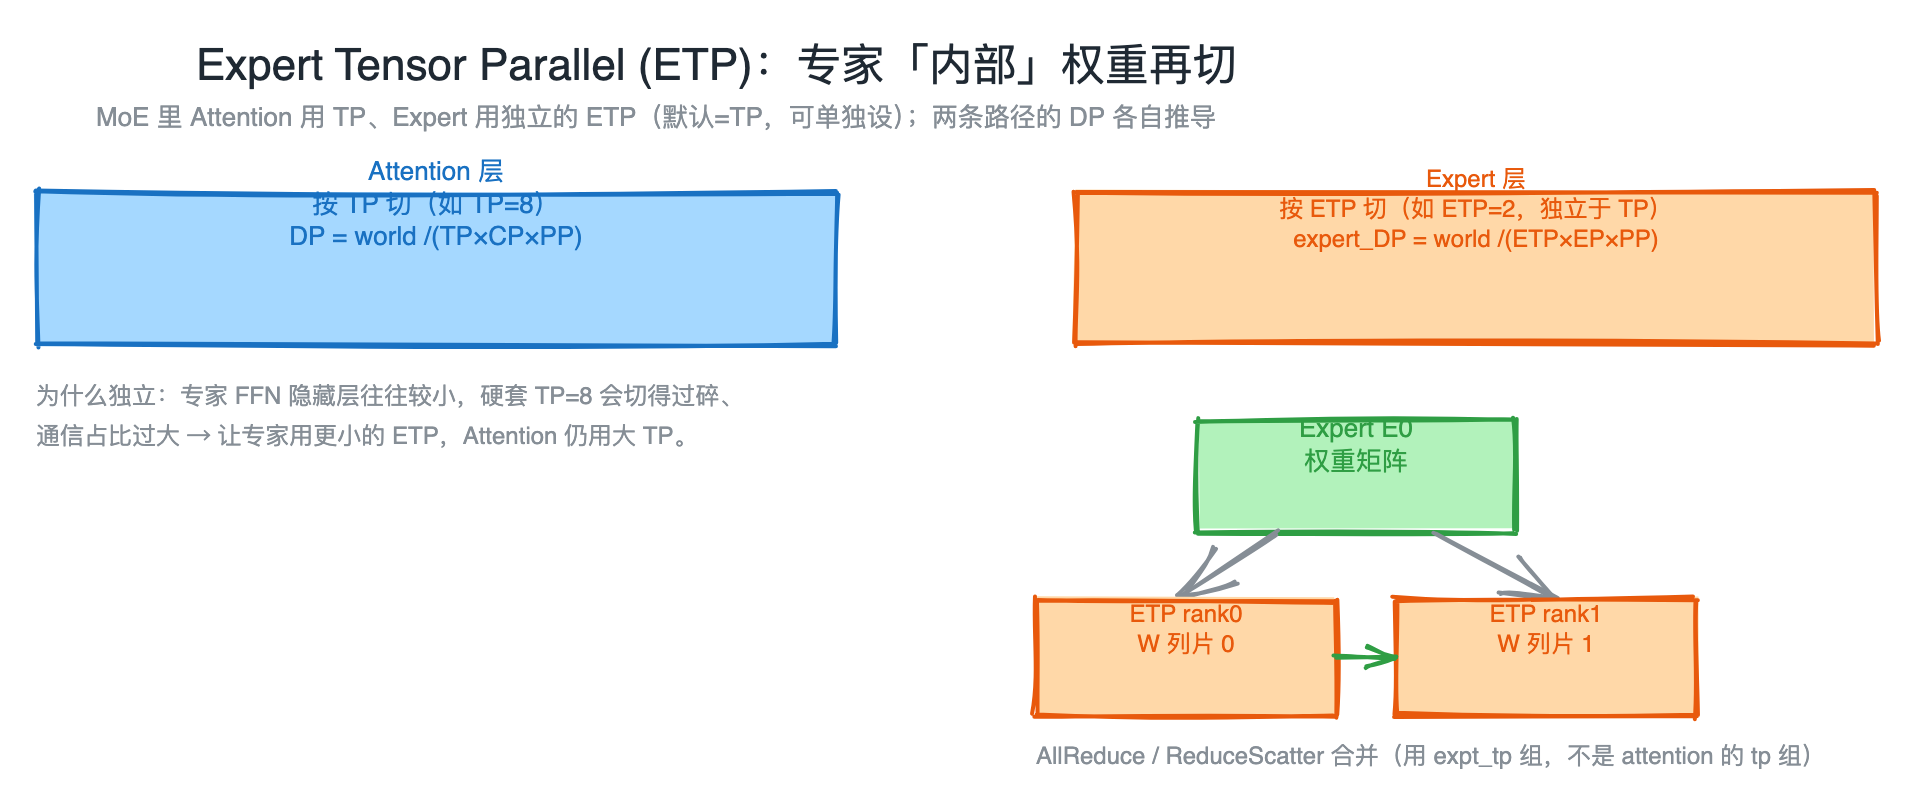
图源:Parallelism-ETP.excalidraw(可编辑)
MoE 里 Attention 层和 Expert 层对 TP 的需求可能不同。若专家 FFN 隐藏层小(如 1024),硬套 TP=8 会切成每片 128 维——粒度过小、通信占比过大。ETP 让专家层用独立的、更小的张量并行(如 ETP=2),Attention 仍用 TP=8。通过 expert_tensor_parallel_size 配置,默认 ETP = TP。
ETP 有完全独立的进程组(parallel_state.py L56–60)和独立 RankGenerator(cp=1,专家不参与 CP)。Expert 层用 expt_tp 组而非 attention 的 tp 组(moe/experts.py)。于是两路 DP 各自推导:
Attention 层: DP        = world /(TP × CP × PP)
Expert 层:    expert_DP  = world /(ETP × EP × PP)
# 例 32 GPU, TP=8, ETP=2, EP=4, PP=2:  DP=2, expert_DP=2
约束:world 整除 ETP×EP×PP;Expert 与 Attention 必须用相同 PP 组;order 不以 pp 结尾时两路 DP 须相等。
9. Rank 映射:五维并行怎么落到 GPU#
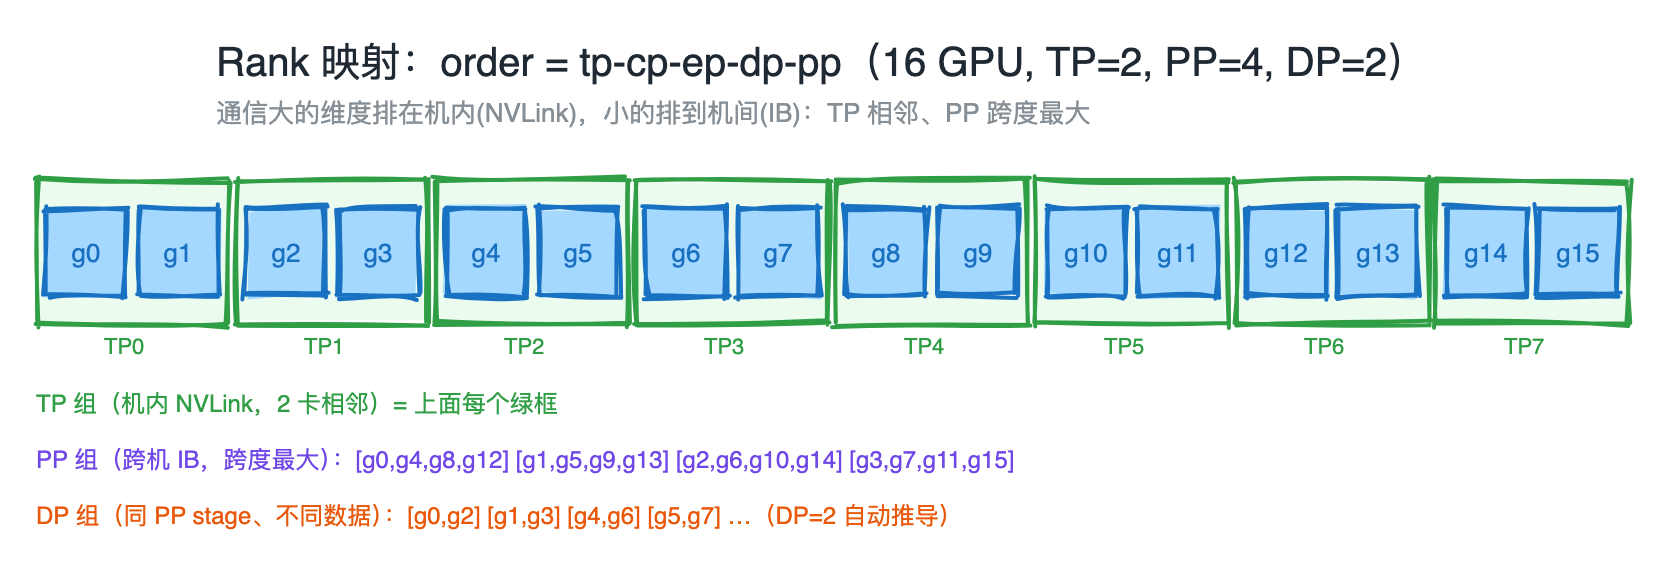
图源:Parallelism-rankmap.excalidraw(可编辑)
RankGenerator(parallel_state.py L446)按 order(默认 "tp-cp-ep-dp-pp")把 GPU 编号分解到各维度。设计原则:通信量大的维度排在机内(NVLink),小的排到机间(IB)——所以 TP 组编号最连续(同机 NVLink),PP 组跨度最大(可跨机,P2P 量小)。
10. 组合实战与约束#
| 模型规模 | 推荐 | 说明 |
|---|---|---|
| 1B–7B | DP only | 单卡放得下 |
| 7B–20B | TP + DP | TP=4/8 走 NVLink |
| 20B–100B | TP + PP + DP | 加流水线跨节点切层 |
| 100B+ | TP + PP + DP + CP | 长序列加 CP |
| MoE | TP/ETP + PP + DP/expert_DP + EP | 专家层可单独设 ETP |
关键约束:① world 整除 TP×CP×PP;② 单个 RankGenerator 的 EP/CP 不同时 >1,但全局 CP 与 EP 可通过两套路径组合;③ VPP 要求 PP>1;④ SP 要求 TP>1;⑤ world 整除 ETP×EP×PP,ETP 默认 = TP;⑥ order 不以 pp 结尾时两路 DP 须相等。
源码地图:parallel_state.py(进程组/RankGenerator)· tensor_parallel/layers.py(Column/RowParallelLinear)· tensor_parallel/mappings.py(通信原语)· pipeline_parallel/schedules.py(1F1B/交错)· distributed/distributed_data_parallel.py(DDP)· transformer/moe/token_dispatcher.py、experts.py(MoE/ETP)。
11. 要点回顾#
七种策略各拆一样东西、配一种通信,在进程组约束下组合。 TP 拆权重、SP 拆激活(复用 TP 组)、PP 拆层(micro-batch 填气泡)、DP 拆数据(+分布式优化器=ZeRO-1/2)、CP 拆序列(Ring 交换 KV)、EP 拆专家(AllToAll 路由)、ETP 拆专家内部权重(独立于 Attention 的 TP)。两条等式
world=TP×CP×DP×PP与world=ETP×EP×expert_DP×PP是骨架;TP 走机内 NVLink、PP 放机间、DP/expert_DP 自动推导。
参考:Megatron-LM 源码(
core_v0.18.0)· arXiv:1909.08053 · arXiv:2104.04473 · arXiv:2205.05198
版本源码:Megatron-LM core_v0.18.0 parallel_state.py。表中模型规模与并行组合只是规划起点,不能代替显存估算和拓扑测量。
延伸阅读#
- MLA:潜在表示压缩与解耦 RoPE:如何用压缩表示减少 KV Cache,并处理 RoPE 与矩阵吸收的冲突?
- 工程基础:数据、损失与参数更新:语料、有效监督、token 预算与参数更新次数之间如何对应?