MLA:潜在表示压缩与解耦 RoPE#
本页内容10 个部分
查看概览图
把 K/V 压成一个潜向量,
再单开一段承载 RoPE
解码是带宽瓶颈,cache 越大越慢。MLA 不减头数,而是把所有头的 K/V 一起投影到低维潜空间,只缓存它。
2·n_h·d_h效果最好,cache 最大2·d_h最省,但通常掉点g 组,组内共享2·g·d_h折中(Llama-2/3 用)c_KVd_c + d_r≈ MHA 效果,cache 比 GQA 还小压缩只为省激活
-
c_Q = W_DQ · h_t不进 cache -
内容段
q_C = W_UQ · c_Q -
每头一份
q_R = RoPE(W_QR · c_Q)
只有两样东西进 cache
-
★ 缓存 d_c
c_KV = W_DKV · h_t -
不物化
k_C = W_UK · c_KV随用随算 / 被吸收 -
不物化
v_C = W_UV · c_KV吸收进 W_O -
★ 缓存 d_r
k_R = RoPE(W_KR · h_t)全头共享,绕开压缩
两段分数相加
-
a = softmax(qᵀk / √(d_h + d_r)) -
o = a · v_C -
u = W_O · o
content 段没有 RoPE,可以照常把 WUQ⊤WUK 提前合并进 query 侧;rope 段维度只有 d_r,单独算。
旋转矩阵夹在中间变成 Rs−t,同时依赖 query 位置 t 和 key 位置 s,没法提前合并成固定矩阵。解耦 RoPE 就是把「携带位置」和「携带内容」拆成两路来绕开它。
MLA,全称 Multi-head Latent Attention(多头潜在注意力),是 DeepSeek-V2 提出、V3 沿用的注意力变体。
一句话版本:
MLA 把每个 token 的 K/V 压成一个低秩潜向量
c_KV,推理时只缓存这个潜向量(外加一小段专门走 RoPE 的 key),缓存节省比例取决于对照架构与维度;模型质量需要实验证据。
1. 为什么需要 MLA:KV cache 才是瓶颈#
自回归解码时,模型要把过去所有 token 的 K、V 存下来,避免每生成一个 token 都重算整段序列。这就是 KV cache。
它的大小(每个 token、每一层)是:
cache_per_token = 2 * n_h * d_h        # 2 是 K 和 V
总量            = 2 * n_layers * seq_len * n_h * d_h * batch * bytes
问题在于:
长上下文 (seq_len 大)  -> cache 线性膨胀
大 batch              -> cache 线性膨胀
显存装不下 cache,就只能减小 batch;而且每生成一个 token 都要把整个 cache 从显存读一遍,解码常受带宽限制,但瓶颈也随 batch、上下文、矩阵吸收方式和 kernel 变化。
所以省 KV cache ≈ 同时省显存、提吞吐。MHA → MQA → GQA → MLA 这条线,主线就是「怎么少缓存一点 K/V,又不掉点」。
2. MHA / MQA / GQA / MLA 对比#
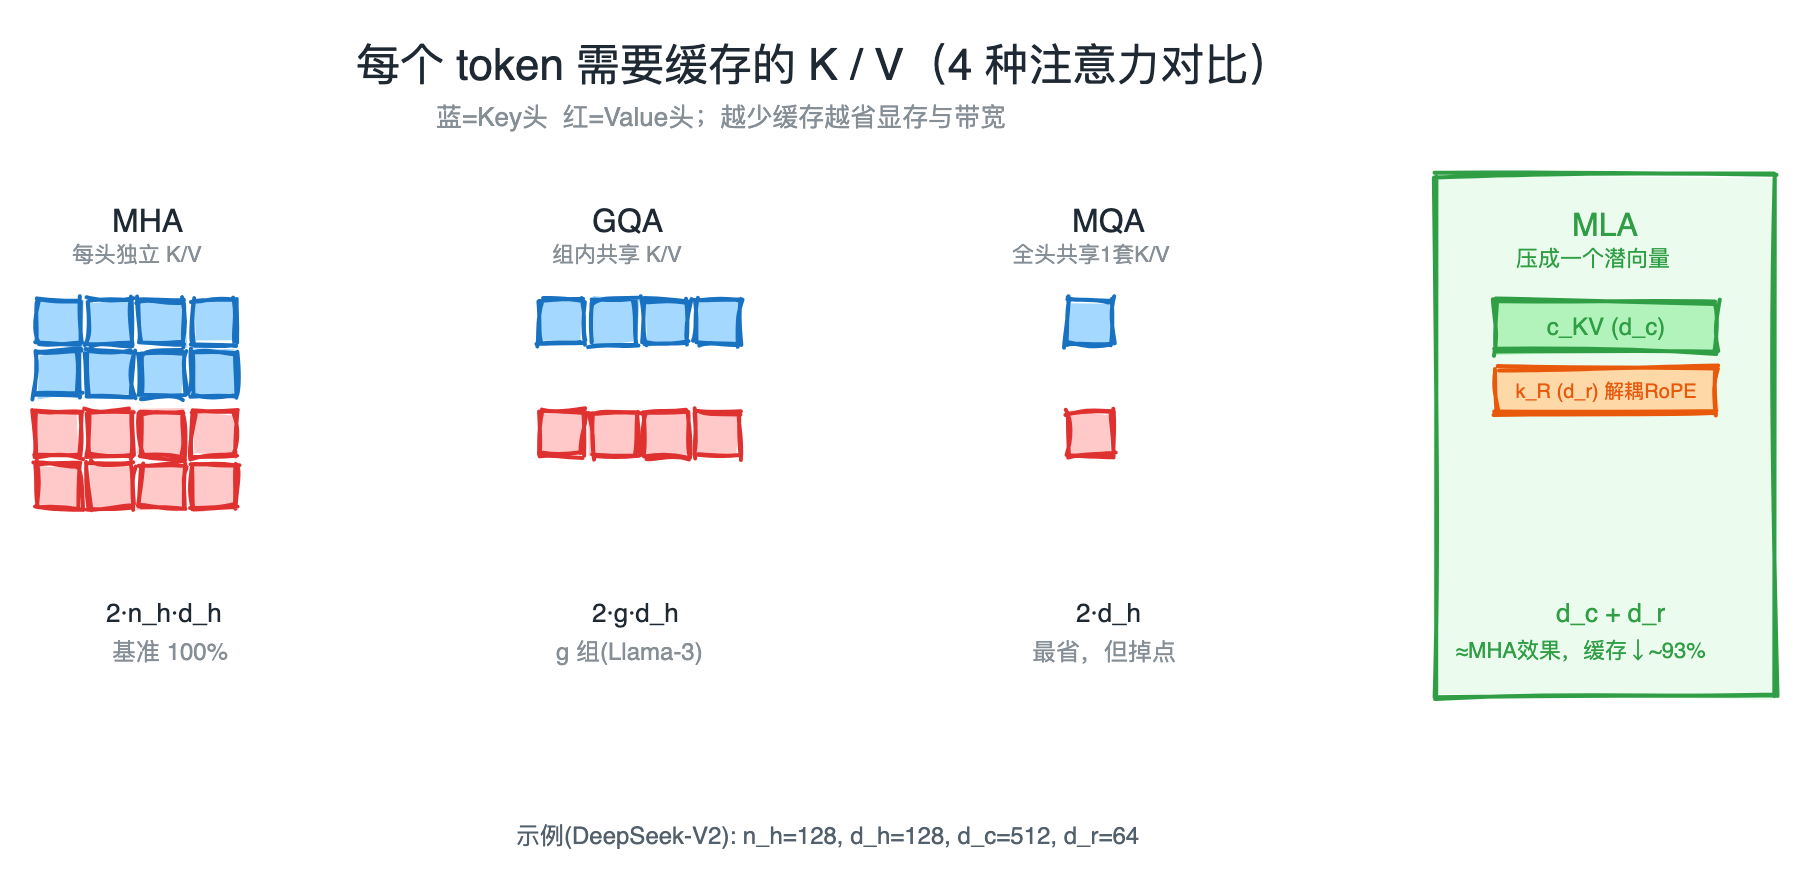
图源:MLA-cache.excalidraw(可编辑)
| 方式 | 做法 | 每 token 缓存 | 代价 |
|---|---|---|---|
| MHA | 每个 head 独立 K/V | 2·n_h·d_h |
头间不共享,cache 较大;质量不是普适排序 |
| MQA | 所有 head 共享 1 套 K/V | 2·d_h |
cache 小;质量取决于模型与训练 |
| GQA | 分 g 组,组内共享 |
2·g·d_h |
折中(Llama-2/3 用) |
| MLA | 压成低秩潜向量 c_KV |
d_c + d_r |
是否小于 GQA 取决于 与 |
MQA/GQA 是**靠减少 K/V 的「头数」**来省 cache,是模型参数化约束,不能无条件等同于对已有表示做无损/有损压缩;MLA 换了个思路:不丢头,而是把所有头的 K/V 一起投影到一个低维潜空间,缓存这个潜向量,用的时候再升维还原。
3. 核心:K/V 的低秩联合压缩#
设某 token 的隐藏态为 。
下投影(压缩) —— 内容分支要缓存的潜向量(此外还有第 6 节的 RoPE key):
上投影(还原) —— 用的时候才把潜向量升回每个 head 的 K、V:
注意:缓存的只有 (维度 ),不缓存 、(它们随用随算)。上标 表示这是「内容(content)」部分,区别于后面的 RoPE 部分。
对 query 也做同样的低秩压缩,但这不是为了省 cache(query 不进 cache),而是为了减少训练时的激活显存:
4. 矩阵吸收:为什么压缩还能不掉速#
只缓存 似乎要付出代价:算 attention 时不是得先升维成 才能点乘吗?那升维的算力不就省不掉了?
关键技巧是矩阵吸收(matrix absorption)。看 attention 分数的内容部分:
是一个固定矩阵,可以提前合并进 query 侧权重。于是推理时:
压根不用把 c_KV 升维成 k_C,
直接拿 query(已吸收 W_UK)和缓存的 c_KV 做内积即可。
上面的 query / key 公式应对每个 head 分别使用对应的上投影矩阵。Value 侧也必须保留 head 索引,因为各 head 的 attention 权重不同:
所以 也不用真的物化。结论:推理时只需缓存 ,K 和 V 从头到尾都不必重建。
5. 拦路虎:RoPE 和矩阵吸收冲突#
上面的吸收有个前提:query 和 key 之间是「干净的」线性变换。但 RoPE 会在中间插一个依赖位置的旋转矩阵 :
中间夹了个 ,它同时依赖 query 位置 和 key 位置 ,没法提前合并成一个固定矩阵——矩阵吸收失效。
换句话说:RoPE 想作用在 上,但 是从 临时升维出来的,而我们恰恰不想物化 。 两个需求直接打架。
6. 解法:解耦 RoPE(Decoupled RoPE)#
DeepSeek 的做法是把「携带位置」和「携带内容」拆成两路:内容部分继续走压缩+吸收,另开一小段专门维度承载 RoPE,绕开压缩。
每个 head 的 query / key 都拆成 content 段 + rope 段,拼接起来:
其中 rope 段:
注意 是直接从 算的(不经过 ),而且全头共享,所以只多缓存一个 维向量。
attention 分数变成两段之和:
- content 段:没有 RoPE,可以照常做矩阵吸收,只认 ;
- rope 段:维度很小(),单独算,正常承载相对位置信息。
所以推理时缓存 = ( 维)+ ( 维),合计 。 这正是第 2 节表格里 MLA 的那一行。
7. 完整前向(汇总)#
输入 h_t
  │
  ├── Query:c_Q = W_DQ h_t
  │        q_C = W_UQ c_Q                       # 内容段
  │        q_R = RoPE(W_QR c_Q)                 # rope 段(每头)
  │        q   = [q_C ; q_R]
  │
  ├── K/V:  c_KV = W_DKV h_t        ★缓存(d_c)
  │        k_C = W_UK c_KV                       # 内容段(随用随算/吸收)
  │        v_C = W_UV c_KV                       # 随用随算/吸收进 W_O
  │        k_R = RoPE(W_KR h_t)     ★缓存(d_r)   # rope 段(全头共享)
  │        k   = [k_C ; k_R]
  │
  └── Attention:a = softmax(qᵀk / √(d_h + d_r))
              o = a · v_C
              u = W_O o
最核心的两点直觉:
1. K/V 不丢头,而是一起压到低维潜向量 c_KV,只缓存它。
2. RoPE 单开一小段维度(解耦),让内容段还能做矩阵吸收。
8. DeepSeek-V2 的实际维度#
d        = 5120          # hidden
n_h      = 128           # 注意力头数
d_h      = 128           # 每头维度
d_c      = 512   (= 4·d_h)   # KV 压缩维(要缓存)
d_c'(Q)  = 1536              # query 压缩维(不缓存)
d_r      = 64   (= d_h / 2)  # 解耦 RoPE 维(要缓存)
每 token 缓存量对比:
MHA :  2 · n_h · d_h = 2 · 128 · 128 = 32768  元素
MLA :  d_c + d_r     = 512 + 64      =   576  元素
约为 MHA 的 1.75%(论文口径:等效于只有 2.25 组的 GQA,但效果对标甚至超过 MHA)。这是上述维度假设下的缓存元素数比较(1.7578%),不是相对于任意 GQA 配置的比例,也不是质量保证。
9. 要点回顾#
MLA = 低秩压缩 K/V(只缓存潜向量
c_KV) + 解耦 RoPE(单开d_r维承载位置,让内容段仍可矩阵吸收)。 缓存从2·n_h·d_h降到d_c + d_r,具体节省比例与质量需按模型配置和评估结果比较。
原始资料:DeepSeek-V2 技术报告。矩阵吸收描述数学上的可行实现;prefill / decode kernel 可以采用不同路径,不代表所有实现都不会物化 K/V。
延伸阅读#
- KV Cache:自回归生成中哪些计算可以缓存,显存代价如何估算?